„Das dürfen wir nicht in die KI geben.” Diesen Satz höre ich in Steuerkanzleien, Pflegediensten, Anwaltsbüros und Verwaltungen fast wörtlich gleich. Und er stimmt. Wer einer Schweigepflicht unterliegt, kann eine Mandantenmail mit Steuer-ID und Kontonummer nicht einfach in ChatGPT kopieren und auf das Beste hoffen.
Das Problem ist nur: Genau diese Betriebe hätten am meisten davon. Sie schreiben jeden Tag dutzende Antworten, Zusammenfassungen und Übergaben, die sich ähneln. Also bleibt die KI draußen, und die Arbeit bleibt liegen.
Ich habe deshalb einen Filter gebaut, der zwischen deinem Betrieb und der KI sitzt. Er ersetzt Namen, Kontonummern, Adressen und Kennungen durch Platzhalter, bevor der Text zur KI geht, und setzt die echten Angaben erst in der fertigen Antwort wieder ein. Die KI arbeitet mit [PERSON_1] und [IBAN_CODE_1] und hat Frau Kowalski nie kennengelernt. Du kannst das hier selbst ausprobieren — und ich erkläre in diesem Beitrag, was so ein Filter leistet und wo seine Grenzen liegen. Beides gehört zusammen.
Wer betroffen ist und was das Gesetz verlangt
Die Schweigepflicht ist keine Datenschutzregel, sondern Strafrecht. § 203 StGB stellt es unter Strafe, ein fremdes Geheimnis unbefugt zu offenbaren, das dir in deinem Beruf anvertraut wurde. Das gilt unter anderem für Ärztinnen und Pflegekräfte, Rechtsanwälte, Steuerberaterinnen, Wirtschaftsprüfer, Sozialarbeiter und Amtsträger.
Seit 2017 dürfen diese Berufe externe Dienstleister einbinden, etwa für IT oder Cloud — aber nur, soweit das erforderlich ist und die Dienstleister zur Verschwiegenheit verpflichtet werden (§ 203 Abs. 3 und 4 StGB). Für Anwälte regelt das § 43e BRAO, für Steuerberater § 62a StBerG, jeweils mit Vorgaben in Textform und strengeren Regeln, wenn der Dienstleister im Ausland sitzt.
Dazu kommt die DSGVO, die ohnehin für jede personenbezogene Angabe gilt. Wer einen KI-Anbieter nutzt, braucht einen Vertrag zur Auftragsverarbeitung, und bei Anbietern außerhalb der EU wird es aufwendiger. Mehr dazu, wie du einen Anbieter auswählst, steht in meinem Beitrag über souveräne KI und europäische Anbieter.
Kurz gesagt: Es ist nicht verboten, KI zu nutzen. Aber jeder Name und jede Nummer, die zum KI-Anbieter geht, zieht Pflichten nach sich. Der einfachste Weg, diese Pflichten klein zu halten, ist, möglichst wenig dorthin zu schicken.
Wie der Datenschutzfilter arbeitet
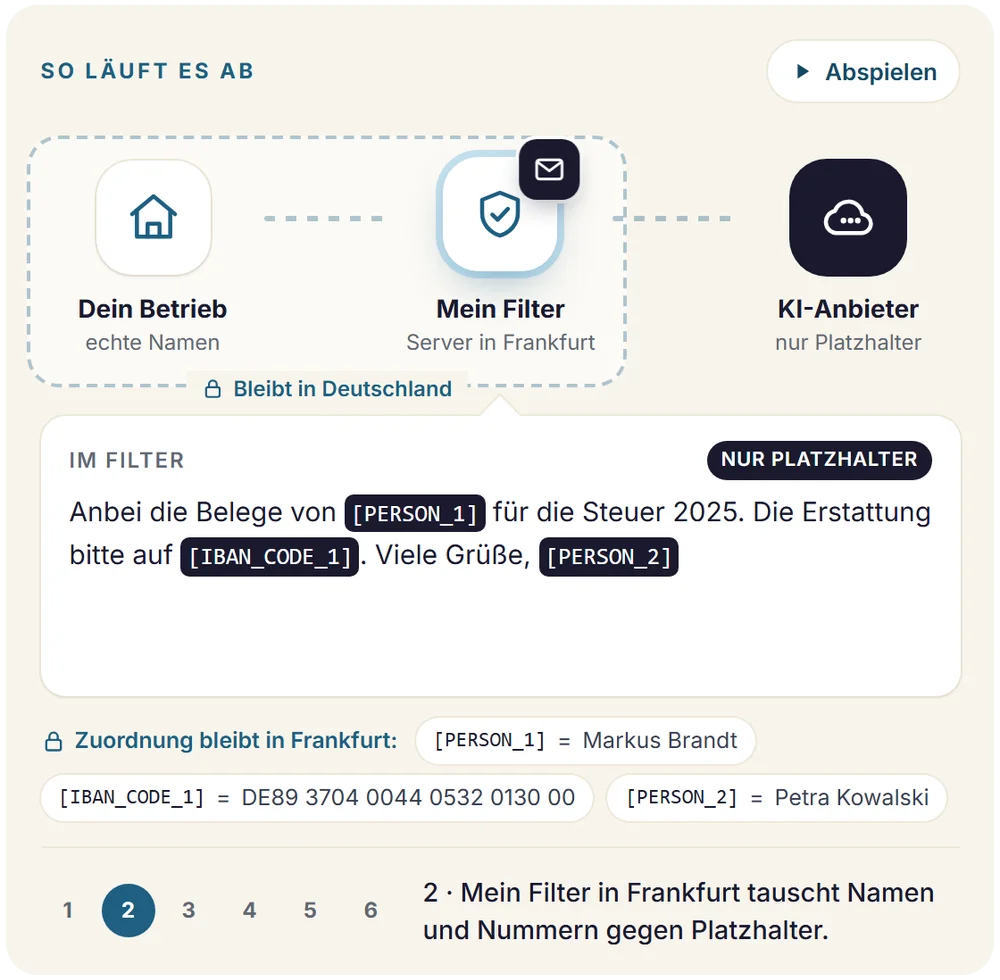
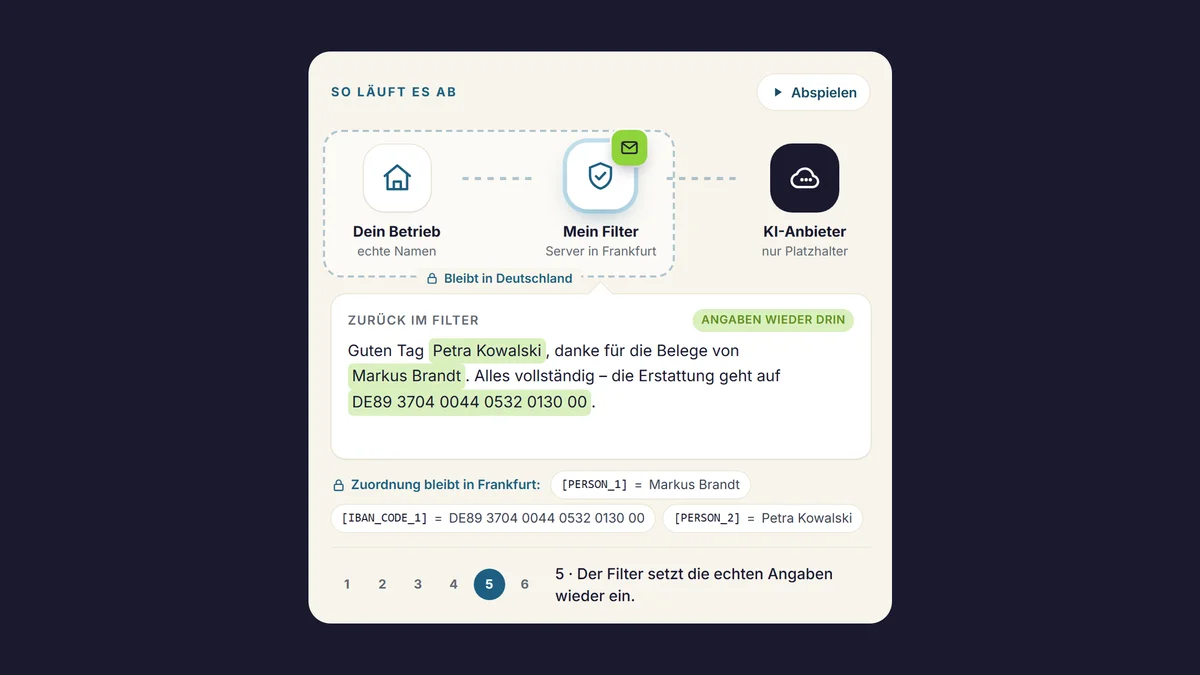
Der Ablauf hat drei Stationen, und zwei davon bleiben in Deutschland:
- In deinem Betrieb entsteht ein Text mit echten Angaben, etwa eine Mandantenmail mit Steuer-ID, Steuernummer und IBAN.
- Mein Filter auf einem Server in Frankfurt erkennt die Angaben und tauscht sie gegen Platzhalter. Die Zuordnung „[PERSON_1] = Markus Brandt“ bleibt auf diesem Server.
- Der KI-Anbieter bekommt nur den Text mit Platzhaltern, schreibt die Antwort und schickt sie zurück. Der Filter setzt die echten Angaben wieder ein, und bei dir kommt eine fertige Antwort mit den richtigen Namen an.
So sieht das mit einem echten Beispiel aus der Vorführung aus:
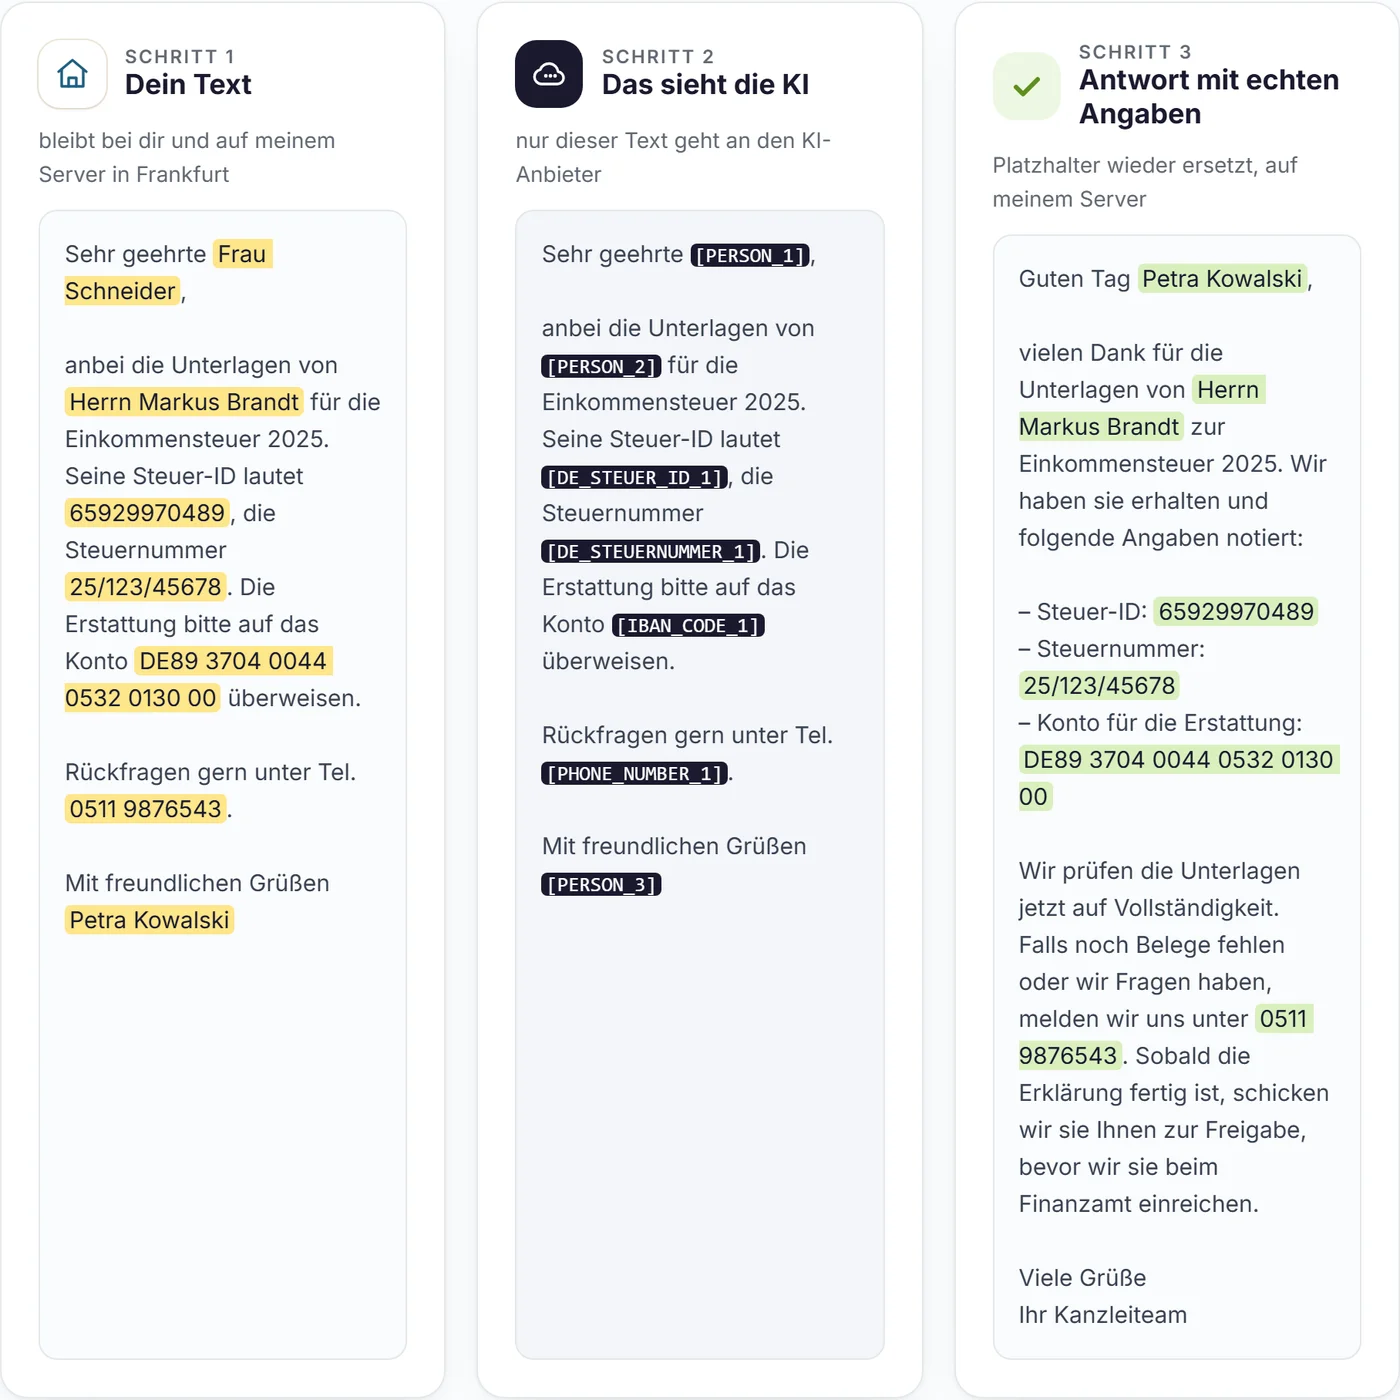
Links steht, was du eingibst. In der Mitte steht wörtlich das, was die KI zu sehen bekommt: kein Name, keine Steuer-ID, keine IBAN, keine Telefonnummer. Rechts steht die Antwort, die du verschicken kannst — die KI hat sie geschrieben, ohne zu wissen, um wen es geht.
Technisch steckt dahinter Microsoft Presidio, ein quelloffenes Werkzeug zum Erkennen personenbezogener Angaben. Ich habe es für deutsche Texte erweitert: Namen mit Anrede und aus einer Vornamenliste, IBAN mit Prüfsumme, Steuer-ID mit Prüfziffer, Steuernummer, Sozialversicherungsnummer, Telefonnummern, Straße mit Hausnummer, Postleitzahl mit Ort, Kfz-Kennzeichen und Geburtsdaten. Gleiche Werte bekommen gleiche Platzhalter, damit die KI erkennt, dass zweimal dieselbe Person gemeint ist.
Was das bringt — und was ausdrücklich nicht
Hier wird es wichtig, denn bei diesem Thema wird gern zu viel versprochen.
Der Filter pseudonymisiert, er anonymisiert nicht. Die Zuordnung existiert ja, sonst könnte er die Namen nicht wieder einsetzen. Für deinen Betrieb bleiben die Daten deshalb personenbezogen, die DSGVO gilt weiter (Art. 4 Nr. 5 DSGVO und Erwägungsgrund 26). Die DSGVO nennt Pseudonymisierung aber ausdrücklich als Schutzmaßnahme (Art. 25 und Art. 32). Sie senkt das Risiko deutlich — sie macht es nicht zu null.
Der Vertrag mit dem KI-Anbieter bleibt nötig. Ein Filter ersetzt keine Auftragsverarbeitung und keine Verschwiegenheitsverpflichtung. Er sorgt dafür, dass beim Anbieter möglichst wenig ankommt, falls dort doch einmal etwas schiefgeht.
Der Inhalt kann eine Person verraten, auch ohne Namen. „Die Patientin mit der seltenen Erkrankung aus dem Nachbardorf” ist ohne Namen trotzdem erkennbar. Gesundheitsangaben bleiben Gesundheitsangaben. Ein Filter erkennt Namen und Nummern, keine Zusammenhänge.
Kein Filter erkennt alles. Ich habe meinen an 15 Mustertexten aus zehn Branchen gemessen: Steuerkanzlei, Pflege, Anwalt, Arztpraxis, Personal, Versicherung, Hausverwaltung und weitere. Alle 83 Angaben waren am Ende verdeckt, darunter Namen, die zugleich Wörter sind, wie Koch, Wolf oder Weiß. Das klingt gut, ist aber für eine Zusage zu wenig: Die Texte habe ich selbst geschrieben. Bevor der Filter bei einem Betrieb echte Arbeit macht, messe ich ihn deshalb an 20 bis 30 echten, geschwärzt freigegebenen Texten aus genau dieser Branche.
Bilder und Scans sind nicht abgedeckt. Der Filter arbeitet mit Text. Ein eingescannter Bescheid oder ein Foto einer Pflegedokumentation braucht einen eigenen Schritt davor.
Ob das in deinem konkreten Fall reicht, um von einem „Offenbaren” im Sinne von § 203 StGB wegzukommen, entscheidet nicht der Filter, sondern der Inhalt — und im Zweifel deine Kammer oder dein Datenschutzbeauftragter. Ich halte es für den deutlich besseren Ausgangspunkt als den Status quo, in dem Mitarbeitende Texte heimlich in private KI-Konten kopieren, weil der Betrieb keine Lösung anbietet.
Wo das im Alltag hilft
Die naheliegenden Einsätze sind die, bei denen viel ähnlicher Text entsteht und die echten Angaben nur drin stehen, weil sie eben drin stehen:
- Steuerkanzlei: Eingangsbestätigungen, Rückfragen zu fehlenden Belegen, Zusammenfassungen von Bescheiden für den Mandanten.
- Pflegedienst: Übergaben zusammenfassen, Angehörigen-Mails beantworten, Dokumentation in lesbare Sätze bringen.
- Anwaltsbüro: Sachverhalte strukturieren, Fristen aus Schreiben herausziehen, Entwürfe für Standardantworten.
- Verwaltung und Personal: Anträge vorsortieren, Antworten auf Bürger- oder Bewerberanfragen vorbereiten.
In allen Fällen bleibt ein Mensch dazwischen, der die Antwort liest, bevor sie rausgeht. Die KI schreibt den Entwurf, nicht das letzte Wort.
So probierst du es aus
Die Vorführung ist öffentlich. Du kannst ein Beispiel aus Steuerkanzlei, Pflegedienst, Rechtsanwalt, Handwerk oder Personalabteilung wählen oder einen eigenen Text eintippen und siehst sofort die drei Schritte von oben. Eingegebene Texte werden nicht gespeichert. Trotzdem gilt: Bitte keine echten Kundendaten, das ist eine Vorführung und kein Arbeitswerkzeug.
Die Vorführung steht auch in meinem Showroom, zusammen mit meinem Telefonassistenten und meinem KI-Zwilling, die du ebenfalls selbst testen kannst.
Wenn du wissen willst, ob so ein Filter in deinen Ablauf passt — vor die KI, die du schon nutzt, oder als Teil einer Automatisierung — schreib mir. Dann schauen wir uns an, welche Texte bei dir anfallen, und messen das an deinen Beispielen, bevor irgendetwas live geht.
Häufige Fragen
Darf ich als Steuerberater oder Anwalt ChatGPT nutzen? Nicht mit Mandantendaten im Klartext, solange keine saubere Grundlage besteht. Dafür brauchst du einen Anbieter mit Vertrag zur Auftragsverarbeitung, eine Verschwiegenheitsverpflichtung nach § 62a StBerG beziehungsweise § 43e BRAO und eine Prüfung, wo die Daten verarbeitet werden. Ein Filter davor senkt das Risiko, ersetzt diese Schritte aber nicht.
Ist ein Datenschutzfilter DSGVO-konform? Ein einzelnes Werkzeug ist nie für sich „DSGVO-konform”. Entscheidend ist der ganze Ablauf: Rechtsgrundlage, Verträge, technische Maßnahmen, Dokumentation. Pseudonymisierung ist eine der Maßnahmen, die die DSGVO ausdrücklich empfiehlt. Sie ist ein Baustein, kein Freifahrtschein.
Was ist der Unterschied zwischen Pseudonymisierung und Anonymisierung? Bei der Anonymisierung lässt sich die Person mit vertretbarem Aufwand nicht mehr bestimmen, auch nicht vom Betrieb selbst. Bei der Pseudonymisierung gibt es eine Zuordnung, die getrennt aufbewahrt wird. Der Filter pseudonymisiert: Die Zuordnung bleibt auf dem Server in Frankfurt, der KI-Anbieter bekommt sie nie.
Sieht der KI-Anbieter wirklich keinen Namen? Er sieht, was der Filter erkannt und ersetzt hat. Bei meiner Messung waren alle Angaben verdeckt, aber kein Erkennungsverfahren ist vollständig. Ein ungewöhnlicher Name ohne Anrede in Kleinschreibung kann durchrutschen. Deshalb messe ich vor jedem Einsatz an echten Texten der Branche.
Wo laufen die Daten? Der Filter und die Zuordnung laufen auf meinem Server in Frankfurt. Nur der Text mit Platzhaltern geht zum KI-Anbieter. In der Vorführung ist das Claude von Anthropic; im Einsatz kann der Filter vor jedem Sprachmodell sitzen, auch vor einem europäischen.
Funktioniert das auch mit PDFs und eingescannten Dokumenten? Mit Text-PDFs ja, wenn der Text vorher ausgelesen wird. Eingescannte Dokumente und Fotos brauchen erst eine Texterkennung. Das ist machbar, aber ein eigener Schritt, den ich bei Bedarf dazubaue.